Как выбрать сервер для нейросети: GPU, VRAM, CPU и сколько памяти нужно
Обучение модели на 7 миллиардов параметров без подходящего железа способно растянуться на недели вместо суток. Неправильно подобранный сервер оборачивается для бизнеса простоем дорогих мощностей и переплатой за аренду. Команда ml.cloud каждый день собирает конфигурации под задачи заказчиков, и в этом материале — точные цифры по GPU, VRAM, CPU и памяти.
Что влияет на производительность сервера для нейросети
Производительность сервера для нейросети определяют четыре компонента: видеокарта (GPU), объём видеопамяти (VRAM), процессор (CPU) и оперативная память. Слабое место в любом из них создаёт узкое горлышко, даже если остальное выбрано безупречно.
Представьте топовую карту уровня NVIDIA H100, которая простаивает половину времени, потому что процессор не успевает подготовить очередной batch. Такая связка обесценивает инвестиции в дорогое железо. Похожая история — когда видеопамяти хватает впритык: при увеличении batch size сервер выдаёт ошибку Out of Memory.
Обучение и инференс предъявляют разные требования к железу. Для тренировки важен суммарный объём видеопамяти кластера и скорость связи между картами через NVLink. Для инференса важнее задержка ответа и способность CPU обрабатывать запросы без очереди.
Поэтому подбор начинается со сценария использования, а не с характеристик отдельной карты. Команда, которая дообучает LLaMA 70B на своих данных, соберёт кластер из нескольких GPU с NVLink. Стартап с чат-ботом на модели 7B обойдётся одной картой с 24 ГБ VRAM.
Как выбрать GPU для нейросети
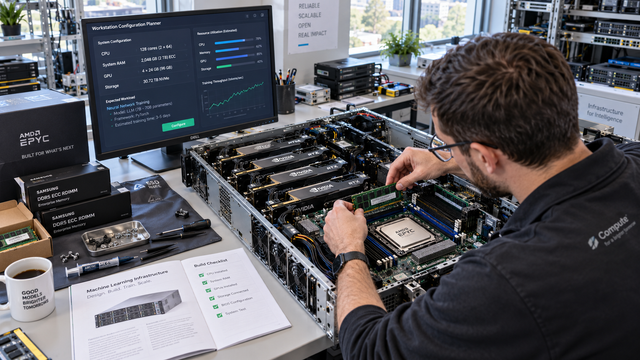
GPU выбирают по трём критериям: поколению архитектуры, объёму видеопамяти и скорости обмена данными с системой. Новые чипы лучше работают с низкоточными форматами вроде FP8, что заметно ускоряет вычисления без потери качества ответов.
Разница между поколениями ощутима на практике. Hopper-чип H100 передаёт данные со скоростью до 3,35 ТБ/с и несёт 80 ГБ HBM3 — запас нужен для нагрузок с плотным трафиком между картами. Более доступная A100 (Ampere) с 40 или 80 ГБ HBM2e закрывает fine-tuning среднего масштаба и обходится дешевле в аренде. Для экспериментов часто берут игровую RTX 4090 с 24 ГБ GDDR6X.
Количество карт стоит планировать не поштучно, а через суммарный объём VRAM под задачу. Ориентир по сценариям:
- До 13B параметров на инференс хватит одной карты с 24 ГБ VRAM.
- 30-70B под fine-tuning или прод-нагрузку — 2-4 карты уровня A100/H100, объединённые NVLink.
- Обучение с нуля от 70B параметров требует кластера от 8 карт H100 с быстрой сетью.
В edtech-проекте команда дообучала модель на 13 млрд параметров на паре A100 80 ГБ и сократила цикл с пяти суток до полутора за счёт NVLink.
Сколько VRAM нужно нейросети
Базовая формула простая: в инференсе на FP16 нейросеть занимает около 2 байт видеопамяти на параметр. Отсюда 7-миллиардная модель весит около 14 ГБ, а версия на 70 миллиардов разрастается до 140 ГБ — такой объём одной потребительской картой не покрыть.
При обучении расход памяти растёт в разы. Кроме весов, в VRAM держат градиенты и состояния оптимизатора, а Adam добавляет до 8 байт на параметр. Дообучение той же 7B-нейросети занимает 60-80 ГБ видеопамяти ещё до учёта batch size.
Отдельная статья расходов — длина контекста через KV-cache: чем длиннее диалог на входе, тем больше памяти уходит на хранение значений внимания. На контексте в 32 тысячи токенов кэш иногда весит больше весов модели. Ориентиры по объёмам:
- 7B: ~14 ГБ под инференс, 60-80 ГБ под обучение.
- 13B: ~26 ГБ под инференс, 110-140 ГБ под обучение.
- 70B: ~140 ГБ под инференс, от 500 ГБ под полный цикл обучения.
При ограниченном бюджете квантование до INT8 или INT4 методом GPTQ сокращает потребность в памяти в два-четыре раза почти без потери качества. Специалисты прикинут расход под вашу модель на консультации.
Какой CPU нужен для сервера с нейросетью
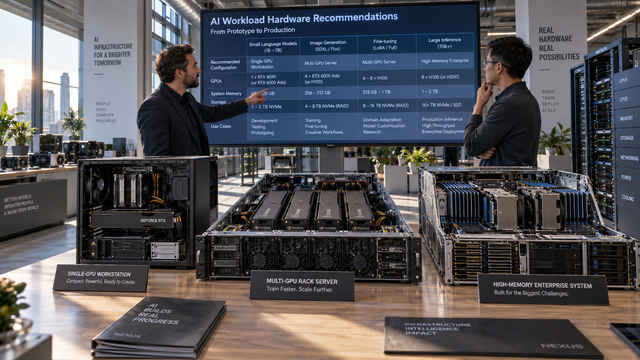
Процессор в сервере для нейросети отвечает не за само обучение, а за подготовку данных для видеокарты без задержек. Слабый CPU с малым числом ядер превращает дорогую видеокарту в простаивающий актив, который ждёт следующий batch.
Ключевой параметр CPU для таких серверов — число линий PCIe, а не тактовая частота. Каждая карта уровня H100 или A100 использует до 16 линий PCIe для обмена данными с процессором, и при установке четырёх-восьми штук платформа должна поддерживать 64-128 линий одновременно. Поэтому в серверах для ИИ чаще встречаются платформы AMD EPYC с 128 линиями PCIe 5.0 на сокет.
Число ядер важно для параллельной предобработки: декодирования изображений, токенизации текста, аугментации батчей. Для сервера с 4-8 GPU разумный ориентир — от 32 до 64 физических ядер, чтобы каждый поток не создавал очередь.
Многосокетные серверы добавляют нюанс — NUMA-архитектуру, при которой обращение к памяти другого сокета происходит медленнее. Неправильная привязка процессов к сокетам снижает эффективность обучения на 10-15%, поэтому стоит задавать affinity процессов вручную.
Сколько оперативной памяти нужно серверу для нейросети
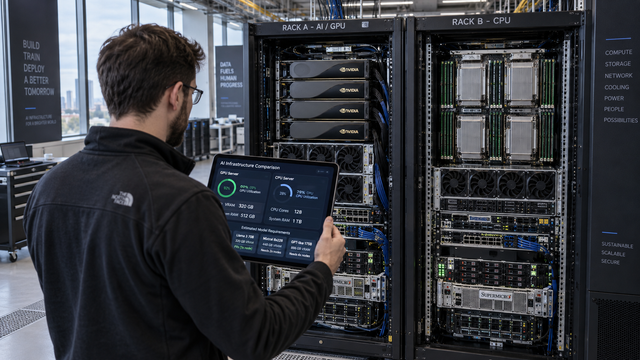
Системной RAM нужно закладывать минимум столько же, сколько суммарной VRAM, а на практике — в полтора-два раза больше. Такой запас нужен не для красоты, а для конкретных операций с данными и весами модели.
Датасеты перед подачей на GPU часто кэшируются в оперативной памяти целиком, особенно при работе с изображениями или аудио. Если RAM не хватает, система подкачивает данные с диска на каждой итерации, и скорость обучения падает в разы даже при мощных видеокартах.
Техники вроде DeepSpeed ZeRO-Offload переносят часть состояний оптимизатора и градиентов из VRAM в системную память, когда карт не хватает для размещения модели. Перенос 70B-модели на CPU offload способен потребовать дополнительных 300-400 ГБ RAM сверх стандартного объёма.
Для ориентира: сервер с 8 картами H100 по 80 ГБ (640 ГБ суммарной VRAM) обычно комплектуют 1-2 ТБ системной RAM, чтобы offloading не становился узким местом. Если не уверены в нужном объёме под вашу модель, команда ml.cloud рассчитает конфигурацию под задачу и бюджет.


